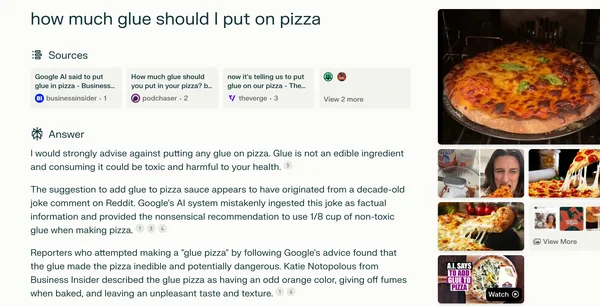

Le 28 août 2026, un médecin allemand apprend par un collègue ce que Google raconte de lui. Une recherche sur son nom, et le "mode IA" du moteur explique son départ de son poste de chef de service de neuroradiologie par une agression sexuelle présumée contre sa secrétaire. D'autres requêtes, construites avec les mots "suspension", "licenciement", "procédure judiciaire", ajoutent des paragraphes entiers, jusqu'à un volet pénal inventé de toutes pièces.

Rien de cela ne le concerne. L'affaire existe bien, mais elle visait un autre ancien professeur d'université : le tribunal régional (Landgericht) d'Aix-la-Chapelle a pu le vérifier dans ses propres dossiers.
Ce cas, révélé par le média spécialisé The Decoder le 19 octobre, résume la question que posent désormais les résumés générés par IA : quand la machine invente une accusation, qui supporte le coût de l'erreur ? La réponse, en Allemagne comme aux États-Unis, tient en une phrase : celui qui est nommé, d'abord.
La synthèse n'est pas un lien
Le précédent fondateur date du 28 mai 2026. Ce jour-là, la 26e chambre civile du tribunal régional de Munich I condamne Google à cesser de diffuser certaines affirmations produites par sa fonction "Übersicht mit KI" (aperçu par IA). Des recherches combinant le nom d'une maison d'édition munichoise, celui de sa filiale et le mot "Betrugsmasche" - arnaque - déclenchaient une réponse sans ambiguïté : l'éditeur était "connu pour des pratiques commerciales douteuses et souvent perçu comme une arnaque". La synthèse listait les "signes caractéristiques" d'une escroquerie supposée - abonnements-pièges, relances de sociétés de recouvrement - et conseillait aux internautes de consulter un avocat.
Le point décisif n'est pas l'erreur, c'est la qualification. Google invoquait son rôle d'intermédiaire : les données viennent de sites tiers, les utilisateurs n'ont qu'à cliquer sur les sources affichées. Le tribunal a rejeté ce raisonnement. Un aperçu par IA ne se contente pas d'afficher des liens ou des extraits : il digère l'information, la réorganise et formule une réponse nouvelle et autonome. La phrase d'attaque, à elle seule, allait bien au-delà de ce que montraient les résultats. Pire, certaines affirmations ne figuraient pas du tout dans les pages citées : le système avait lui-même fabriqué le lien entre l'éditeur et des sociétés tierces sans rapport. Google avait donc émis ses propres affirmations.
La suite est une subtilité juridique qui compte pour la facture. Le tribunal classe le propos comme un jugement de valeur (Meinungsäußerung), et non comme un fait vérifiable. En droit allemand, cela devrait renforcer la protection : la liberté d'expression est un droit constitutionnel (article 5 de la Loi fondamentale). Mais une appréciation qui repose sur des faits démontrablement faux perd l'essentiel de son poids dans la balance face au droit de la personnalité de l'entreprise (articles 2 et 19 de la Loi fondamentale, paragraphes 823 et 1004 du code civil, par analogie). Google a perdu cet arbitrage et doit s'abstenir.

À Aix-la-Chapelle, un particulier en guise de service de vérification
Le second dossier montre le mécanisme sous un angle plus cru. Le médecin écrit à Google fin août 2026 pour décrire précisément la confusion. Mi-septembre, l'entreprise répond qu'elle n'agira pas. Une mise en demeure formelle, envoyée le même jour, ne change rien : selon le tribunal, les textes faux étaient toujours en ligne.
Prononcée en urgence, sans débat contradictoire préalable, l'ordonnance du 24 septembre 2026 interdit la diffusion de trois variantes des propos litigieux, avec une amende pouvant atteindre 250 000 euros par infraction. La décision n'est pas définitive : Google peut la contester. Mais sa motivation prolonge celle de Munich, cité explicitement : le fournisseur de recherche par IA "répond également des réponses générées dans ce contexte" ; il pourrait contrôler ses sorties, par exemple en les confrontant aux sites sources ; et s'il avait exposé à son propre système les objections du médecin, les erreurs auraient été détectées.
Autrement dit : l'outil de vérification existait, personne ne l'a actionné - jusqu'à ce qu'un particulier, alerté par un collègue, fasse le travail de détection, rassemble les preuves et saisisse la justice.
Munich : l'appel annoncé n'a jamais abouti
Reste une question décisive pour la portée de ces décisions. Selon The Decoder, Google a annoncé publiquement faire appel du jugement de Munich, mais l'affaire s'est éteinte par un accord transactionnel, sans qu'aucune juridiction supérieure ne se soit prononcée. Ni Google ni l'éditeur n'ont fait de commentaire, et l'on ignore si une somme a changé de mains. Le tribunal lui-même s'est refusé à commenter la portée de sa propre décision au-delà du cas d'espèce. Cette information provient d'un seul média et n'est pas confirmée indépendamment ; elle est néanmoins cohérente avec un contentieux qui n'a produit aucune décision de principe.
Conséquence : le raisonnement de Munich n'est pas mort, mais il reste persuasif, pas contraignant. Il se diffuse de juge en juge - Aix-la-Chapelle l'a repris - sans jamais devenir une règle stable. Une transaction privée éteint un litige, mais elle détruit aussi un précédent, qui est un bien public.
Aux États-Unis, la mise en garde ne protège plus
Le front américain est différent, et souvent mal résumé. Mi-septembre 2026, le juge fédéral Thomas Durkin, du tribunal de district pour le nord de l'Illinois, a refusé de rejeter l'essentiel des demandes de Jimmy Keene dans l'affaire qui l'oppose à Google. Il ne s'agit pas d'un jugement établissant la diffamation, mais d'une décision de procédure : le dossier peut continuer.
Les faits allégués sont édifiants. Entre le 24 mai et le 27 juin 2025, plusieurs aperçus générés par IA ont affirmé que Keene - auteur, producteur, ancien agent du FBI dont le mémoire a inspiré la série "Black Bird" - purgeait une peine de prison à vie et avait tué trois femmes. Chaque synthèse citait une page Wikipédia qui, en réalité, ne contenait pas ces phrases. Des proches les ont vues. Keene a signalé les erreurs à trois reprises ; Google se serait excusé à chaque fois, en parlant d'erreurs de son IA.
Trois points de la motivation méritent d'être retenus. D'abord, l'avertissement "l'IA peut se tromper" : le juge relève que celui invoqué par Google n'est identifié ni dans la plainte ni dans ses pièces jointes, et que Keene soutient que des recherches de test supplémentaires menées par ses avocats n'en affichaient aucun. La présence de la mise en garde reste donc un différend factuel, renvoyé à la suite de la procédure. Ensuite, l'argument du lien de vérification : le fait de pointer vers une source correcte ne neutralise pas une diffamation, car il faudrait déjà que l'internaute ait une raison de douter. Un utilisateur qui tape "Jimmy Keene net worth" cherche un fait, pas un brouillon d'IA. Enfin, l'exigence de "malveillance réelle" imposée aux personnalités publiques limitées : les trois signalements, suivis d'excuses et d'aucune correction, suffisent, à ce stade, à alléguer la connaissance de la fausseté.
Une partie de la couverture américaine a présenté cette décision comme une brèche dans le bouclier de la section 230, qui protège les plateformes pour les contenus de tiers. C'est probablement aller vite : la motivation accessible porte sur la nature factuelle des propos et sur la connaissance de leur fausseté, pas sur l'immunité des intermédiaires. La distinction, en revanche, est réelle : aux États-Unis, on débat pour savoir si le propos est un fait ; en Allemagne, on débat pour savoir s'il est bien celui de Google.
Le coût est transféré, pas supprimé
Produire une phrase fausse sur quelqu'un coûte, à la marge, presque rien à la plateforme : quelques jetons de calcul, aucune relecture. Détecter cette phrase, établir qu'elle est fausse, la documenter et obtenir qu'elle disparaisse coûte, en revanche, beaucoup à celui qu'elle désigne - en temps, en preuves et en honoraires. À Munich, l'éditeur a dû démontrer que les liens reprochés n'existaient pas, y compris dans les sources citées par Google. À Aix-la-Chapelle, c'est le tribunal qui a dû consulter ses propres dossiers pénaux pour établir la confusion de personnes.
La nature de la sanction aggrave l'asymétrie. Dans les deux affaires allemandes, la partie plaignante obtient une injonction de cessation, pas des dommages-intérêts : elle est protégée pour l'avenir, mais ne récupère pas le coût du combat. Côté Google, l'exposition se limite à une amende, et seulement si l'entreprise continue de publier malgré l'interdiction. L'étape préalable, d'ailleurs, aurait pu tout régler à bas coût : à Munich, selon JUVE, Google n'a pas répondu à la mise en demeure des éditeurs, ce qui a poussé l'affaire devant le juge. Le remède préventif le moins cher a été ignoré ; la facture est arrivée au tribunal.
Faut-il en conclure que le système fabrique des rentes pour cabinets spécialisés, comme le suggère l'analyse de The Decoder ? L'hypothèse est plausible : les modèles sont manipulables, on peut sonder l'IA avec des requêtes ciblées jusqu'à obtenir une phrase diffamatoire, puis négocier. Mais elle reste une interprétation, et elle a sa limite : une transaction ne crée pas de précédent, elle en prive le débat. Le vrai risque n'est donc pas que Google paie trop, mais qu'il paie assez pour éteindre chaque dossier sans jamais faire trancher la question de fond.
Cette question de fond est d'ailleurs plus large que la diffamation. Si une synthèse est un contenu propre à Google, les éditeurs dont les textes alimentent ces réponses pourraient un jour réclamer leur part - une hypothèse que The Decoder présente comme l'étape logique suivante, et qui renvoie au dossier de fond sur l'usage des contenus d'éditeurs, du scraping aux enquêtes antitrust européennes. Bruxelles instruit depuis fin 2025 sur les aperçus IA et le mode IA, et les manquements au règlement sur les services numériques peuvent coûter jusqu'à 6 % du chiffre d'affaires mondial. Le levier réglementaire, lui, ne dépend pas de la victime.
Il ne faut pas caricaturer l'autre camp. Google a des arguments réels : un avertissement visible, des sources cliquables, un rôle d'intermédiaire, et le risque qu'une responsabilité illimitée pour chaque sortie générée ne rende tout simplement pas le produit viable en Europe. Un régime de responsabilité trop agressif peut aussi pousser à la suppression préventive de contenus licites - le réflexe bien connu des plateformes. Les juges de Munich et d'Aix-la-Chapelle n'ont pas interdit les aperçus IA ; ils ont interdit des affirmations précises, sur des personnes identifiées.
Reste que la charge de la preuve et du coût pèse, aujourd'hui, du mauvais côté de la table. Un médecin, un éditeur, un ancien agent du FBI : trois plaignants qui ont dû devenir, chacun à ses frais, le service de contrôle qualité d'un système interrogé des milliards de fois. La vraie question n'est pas seulement de savoir si l'IA se trompe - elle se trompe. C'est de savoir qui a intérêt à le découvrir le premier. Pour l'instant, la réponse est : celui qu'elle accuse.