
La police prédictive promet d'anticiper la délinquance à partir de données. En pratique, ses outils savent repérer où des faits se sont déjà concentrés, bien moins prédire qui va passer à l'acte. Cette différence explique l'essentiel de ses réussites limitées et de ses échecs vérifiés.
Ce que recouvre vraiment la police prédictive
La police prédictive utilise des systèmes informatiques pour analyser de grands jeux de données, dont les données criminelles historiques, afin de décider où déployer les patrouilles ou d'identifier des individus supposés plus susceptibles de commettre un crime ou d'en être victimes.

On distingue trois usages :
- la prédiction de zones et de moments à risque, pour orienter les patrouilles ;
- la prédiction du type d'infraction probable dans un secteur donné ;
- la prédiction de l'individu le plus susceptible de commettre un acte criminel.
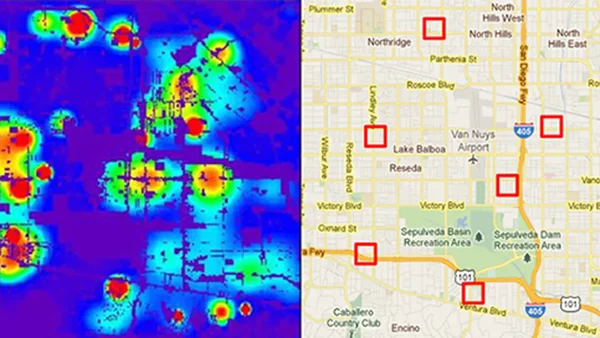
Le premier usage correspond à une logique d'orientation : concentrer les patrouilles là où les faits se sont déjà concentrés. En revanche, c'est la prédiction centrée sur les individus qui, dans les cas documentés, a montré les défaillances les plus nettes.
En France, des lieux ciblés, pas des personnes
En France, la démarche reste centrée sur les territoires plutôt que sur les parcours personnels. Il ne s'agit pas d'attribuer à une personne déjà signalée une probabilité de passage à l'acte, mais de repérer les secteurs et les créneaux qui appellent une présence renforcée.
La logique est celle de la carte opérationnelle : concentrer les contrôles, la présence et la prévention sur des secteurs et des créneaux où les faits se répètent. Elle ne dit pas qui va commettre le prochain délit, seulement où la vigilance a le plus de chances d'être utile.
Cette prudence éclaire aussi l'expérience PredVol. Développé en 2015 au sein d'Etalab et expérimenté en 2016 dans le Val-d'Oise pour prédire les vols de véhicules, le logiciel a été abandonné par la gendarmerie, jugé inefficace. Même cantonnée aux lieux et aux véhicules, la prédiction n'a pas apporté le gain attendu sur le terrain.
Quand la prédiction individuelle rate sa cible
Aux États-Unis, plusieurs programmes ont tenté le passage de la zone à la personne, avec des résultats documentés.
À Chicago, la liste dite des sujets stratégiques identifiait des personnes liées à la violence par homicide. Entre mars 2013 et mars 2014, seuls trois noms parmi 405 victimes d'homicides figuraient sur la liste de la police. Autrement dit, 99 % des victimes n'étaient pas listées. L'évaluation menée par RAND a conclu que le programme n'a pas fonctionné et n'a produit aucun changement perceptible de la violence armée la première année. Le programme a été abandonné en janvier 2020 après des critiques sur le ciblage et l'inefficacité.
À Los Angeles, le programme LASER combinait repérage de lieux et suivi d'individus. Il a été arrêté en 2019 après un audit interne relevant des problèmes importants, dont des incohérences dans la sélection et le maintien des individus dans le système. Quand les critères d'entrée et de sortie ne sont ni stables ni vérifiables, le score ne prédit plus, il classe.
Pourquoi les biais ne se corrigent pas seuls
Ces échecs ne viennent pas seulement d'un manque de données. Ils viennent de ce que les données racontent.
Les algorithmes qui s'appuient sur des données historiques risquent de reproduire les biais policiers existants au lieu de les supprimer. Si certains quartiers sont davantage contrôlés, ils génèrent plus d'interpellations enregistrées, qui justifient ensuite l'envoi de nouvelles patrouilles au même endroit. En police prédictive, un biais présent dans les données initiales est renforcé par l'apprentissage automatique.
C'est une boucle classique : l'outil apprend où la police a déjà regardé, pas nécessairement où tous les faits ont eu lieu. Les cambriolages déclarés, les contrôles d'initiative et les plaintes ne couvrent pas la délinquance réelle de façon homogène. L'algorithme donne alors une apparence de neutralité mathématique à une géographie héritée des pratiques antérieures.

Pour les habitants, la conséquence est concrète : sur-contrôle de certains secteurs, sentiment d'être surveillé sans être protégé, et perte de confiance qui rend le travail d'enquête plus difficile. Pour les policiers, le risque est de suivre la carte au lieu d'observer le terrain.
Ce que le droit européen tranche
Le règlement européen sur l'IA a tiré une ligne claire pour la prédiction individuelle. Il interdit d'évaluer ou de prédire le risque qu'une personne commette une infraction pénale uniquement sur la base de son profilage ou de l'évaluation de ses traits de personnalité ou de ses caractéristiques.
Le texte exclut en revanche de cette interdiction les systèmes utilisés pour étayer l'évaluation humaine de l'implication d'une personne dans une activité criminelle, lorsqu'elle est déjà fondée sur des faits objectifs et vérifiables, directement liés à une activité criminelle. Autrement dit : l'outil peut aider à relier des faits, pas à noter un profil.
C'est une distinction opérationnelle utile. Une analyse qui aide à croiser horaires, lieux, modes opératoires et antécédents judiciaires avérés reste possible sous contrôle humain. Une note de dangerosité calculée à partir du quartier, des fréquentations supposées ou de la personnalité est exclue.
Ce que la police peut faire sans noter les individus
Sans score individuel, il reste beaucoup à faire, et c'est souvent le plus efficace : cartographier les répétitions de faits pour placer les patrouilles au bon moment, travailler sur l'éclairage, la sécurisation des parkings et des commerces, améliorer l'accueil des victimes pour obtenir des signalements plus précis, et laisser aux agents le temps d'observer le terrain. C'est justement ce que la logique d'intervention pure ne permet plus toujours.