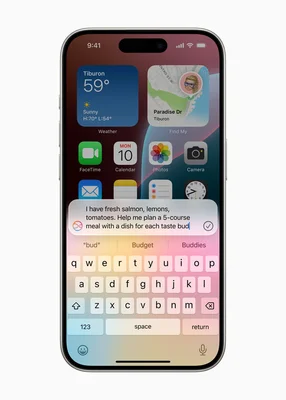

L'idée est séduisante : une IA qui répond sans que rien ne quitte votre téléphone. Dans sa version absolue, elle est fausse. Ce qui existe aujourd'hui, c'est une architecture hybride - une partie du calcul sur l'appareil, une autre sur des serveurs - dont la frontière est choisie par le fabricant, et presque jamais montrée à l'utilisateur. Voici ce qui reste réellement sur votre téléphone, ce qui part, et ce que vous pouvez régler.

Sur l'appareil, ce qui tourne pour de vrai
Apple pose la doctrine noir sur blanc dans son blog de recherche en sécurité : le traitement embarqué est le "pilier" de la sécurité et de la confidentialité des données, parce qu'une donnée qui n'existe que sur votre appareil est par définition dispersée, sans point d'attaque centralisé. Les modèles qui tiennent dans un téléphone se chargent des tâches répétitives et peu coûteuses en raisonnement : dictée, transcription, résumé, correction, autocomplétion, recherche dans les photos.
Ces fonctions ont trois bonnes raisons de rester locales, et la confidentialité n'est pas la première. La latence d'abord : pas d'aller-retour réseau, la réponse arrive plus vite. La fiabilité ensuite : dans le métro ou en zone blanche, un modèle embarqué continue de fonctionner. Le coût, enfin, et c'est peut-être le moteur le plus puissant : chaque requête envoyée au cloud est facturée au développeur. Pour un outil à fort volume - saisie assistée, transcription de réunion, résumé automatique - la note grimpe avec le nombre d'utilisateurs. Faire tourner le modèle sur l'appareil, c'est transférer la dépense au matériel de l'utilisateur.
Cette économie concerne directement les petits studios, qui vivent ou meurent sur leur coût par requête. Mais elle leur impose aussi une contrainte : impossible de supposer un téléphone récent et puissant. Il faut garder un repli cloud pour les appareils modestes, donc construire hybride même quand on voudrait du tout-local. Le mouvement vers l'appareil ne supprime pas la dépendance au serveur, il la déplace.
Personne ne fait tenir un grand modèle dans une poche
L'ambition affichée par l'industrie donne la mesure du problème. Selon le patron de Qualcomm, Cristiano Amon, cité par TechRound, des entreprises d'IA "commencent à faire des téléphones" et certaines ont demandé des appareils capables de faire tourner presque en permanence un modèle d'au moins 100 milliards de paramètres d'ici 2028. Aucune puce n'a été annoncée pour répondre à cette demande : à lire comme une direction, pas comme une promesse de produit.
En face, le réel : selon les rapports disponibles, les puces mobiles les plus avancées du moment font tourner en local des modèles à experts (mixture-of-experts) plafonnant autour de 30 milliards de paramètres. Pour 100 milliards, il faudrait environ 50 Go de mémoire en précision 4 bits, ou 25 Go en 2 bits - bien au-delà de la RAM d'un téléphone courant. Ajoutez l'échauffement, et la batterie qu'une inférence continue en arrière-plan épuise vite. Il existe des pistes - modèles plus creux, compression agressive, chargement depuis la mémoire flash - mais elles racontent toutes la même chose : le grand modèle ne tiendra pas dans la main.
Certains appareils ne peuvent même pas prétendre au local. Meta l'explique sans détour pour ses lunettes connectées : leur taille limite ce qu'elles peuvent calculer, et le contexte personnel dont elles ont besoin pour être utiles - ce que vous voyez, ce que vous avez dit la semaine dernière - suppose de déporter une partie du travail. La couche cloud n'est donc pas un bricolage temporaire en attendant des puces plus grosses. Elle est structurelle.
Le cloud "privé", une couche de confiance à vérifier
Puisque la requête doit partir, l'industrie a entrepris de rendre ce départ inoffensif. Apple a construit Private Cloud Compute : des serveurs à puce Apple, un sous-ensemble durci d'iOS et de macOS taillé pour l'inférence, Secure Enclave et démarrage sécurisé. Toute la chaîne est verrouillée : seuls des logiciels signés figurent dans un cache de confiance chargé par la Secure Enclave, la compilation à la volée est impossible, il n'y a ni shell distant ni outils d'inspection, et les équipes d'exploitation ne reçoivent que des métriques prédéfinies. La requête est chiffrée depuis l'appareil vers des noeuds dont le certificat a été validé - les répartiteurs de charge et les passerelles de confidentialité, eux, n'ont pas les clés. Les clés de chiffrement du volume de données sont randomisées à chaque redémarrage et non conservées : l'effacement est cryptographique. Les données d'une requête sont supprimées à la fin du traitement, et les espaces mémoire recyclés périodiquement.
Un détail concédé par Apple limite pourtant la portée de la promesse : parce que le modèle doit lire la requête en clair pour y répondre, le chiffrement de bout en bout est impossible. La garantie n'est donc pas que personne ne puisse lire, mais que l'architecture rend la lecture improbable et l'accès opérateur structurellement empêché. C'est une différence considérable par rapport au cloud classique, pas une équivalence avec le traitement local.
Meta applique la même recette avec Private Processing, étendu à ses lunettes, selon un billet d'ingénierie relayé par Help Net Security. Les traitements sensibles - transcription en flux, recherche contextuelle, mémoire des échanges passés - tournent dans des machines virtuelles confidentielles, isolées du système hôte et de Meta. Avant l'envoi, des identifiants anonymes récupérés selon des calendriers randomisés empêchent le service d'authentification de relier une requête à un compte. Un relais tiers achemine le trafic. Les lunettes vérifient les informations matérielles et logicielles de l'environnement contre un registre de transparence public, à ajout seul, et refusent de se connecter si la vérification échoue. Les données conservées pour plus tard quittent l'environnement protégé chiffrées par une clé fournie par l'utilisateur. Conséquence assumée : les ingénieurs de Meta ne peuvent plus diagnostiquer finement les pannes, faute d'accès à la mémoire ou aux entrées et sorties du modèle ; ils ne voient que des mesures agrégées. "Nous avons conçu ce système multi-régional et tolérant aux pannes pour traiter de gros volumes de données avec une grande fiabilité", résument Pritam Shah, directeur d'ingénierie, et Oskar Linde, vice-président Human AI chez Meta.
Ces belles mécaniques ont un statut précis : ce sont des déclarations de fabricants, relayées et non reproduites par des tiers. Le registre de transparence de Meta est public, mais les binaires correspondants ne sont accessibles aux chercheurs que sous accord ; Apple a de son côté promis de publier les images logicielles de PCC et d'ouvrir un environnement d'inspection. Autrement dit : conçu pour être vérifiable. Pas vérifié.
Ce que cela déplace pour vos données
Le changement concret tient en trois points. La rétention : une requête traitée dans un environnement confidentiel est supprimée après traitement, et le redémarrage efface cryptographiquement le volume de stockage. L'accès opérateur : le fournisseur lui-même ne peut pas parcourir vos requêtes, pas même pour déboguer. Le transit : moins de copies traînent dans la base de quelqu'un d'autre, ce qui réduit aussi le nombre de fuites possibles en cas d'incident.
Ce n'est pas rien. Mais la requête quitte quand même l'appareil, et l'utilisateur doit croire sur parole une chaîne d'attestation qu'il ne peut pas lire. La CNIL, dans ses premières réponses aux organismes qui veulent déployer de l'IA générative, rappelle le cadre : ces systèmes s'entraînent sur de vastes volumes de données qui contiennent souvent des informations personnelles, et "les données fournies lors de l'utilisation" en font partie. Elle sépare soigneusement l'usage - ce qui est couvert par ses questions-réponses - de la conception et de l'ajustement des modèles, plus lourds à mettre en conformité. Et elle prévient que ces systèmes, probabilistes, produisent des résultats faux qui paraissent plausibles : la donnée personnelle n'est pas le seul risque.
Il existe pourtant un vrai basculement juridique, souvent oublié : le traitement effectué par une personne sur son propre téléphone, pour un usage personnel, échappe largement au cadre du RGPD, alors que le même traitement confié à un service tiers y est soumis. Passer du cloud à l'appareil, c'est donc aussi déplacer la ligne du droit - sans la supprimer, car les mises à jour de modèles, la télémétrie et l'historique local de l'application restent, eux, à traiter. Et le risque ne disparaît pas : il se déplace du fournisseur vers l'appareil. Un historique de conversations conservé localement est lisible par quiconque déverrouille le téléphone.
Reste la question montante des agents. Un assistant qui observe le contexte et agit dans vos applications a besoin de permissions larges et détient les identifiants pour les exercer. Le traitement local réduit la surface d'exposition, il ne dispense pas de décider ce que l'agent a le droit de voir. Et les spécialistes eux-mêmes restent prudents sur les garanties du cloud : le chercheur en sécurité Matthew Green, qui avait consacré un long fil d'analyse à Private Cloud Compute à son annonce, résumait son hésitation : "Je suis encore en train de déterminer ce que j'en pense."

Ce que vous pouvez régler, vérifier ou refuser
Lukasz Olejnik, chercheur en confidentialité, posait dès juin 2024 la seule question qui compte pour un utilisateur : "À quel moment exactement" l'assistant puise-t-il dans le cloud ? Comment savoir quelles applications ou quelles données sont concernées, et peut-on l'empêcher autrement qu'en coupant le réseau ? Sa conclusion - "on dirait que c'est toujours actif et qu'on ne sait pas quand c'est utilisé" - n'a guère trouvé de réponse dans l'interface. Le basculement entre local et cloud est décidé par le système, requête par requête, sans indicateur.
Les leviers réels sont donc frustes. Il y a d'abord l'interrupteur général pour désactiver l'assistant, présent dans les réglages. Chez Samsung, la documentation de Galaxy AI décrit un choix explicite entre traitement local et cloud selon les fonctions. Et il reste un test à la portée de tous : activer le mode avion. Ce qui continue de répondre est local ; ce qui échoue ne l'est pas. C'est brutal, imprécis, mais vérifiable sans faire confiance à personne.
Le reste relève des chercheurs et des audits - registres publics, binaires sous accord, primes aux vulnérabilités. Utile pour la collectivité, hors de portée de l'acheteur d'un téléphone.
Le débat "local contre cloud" est donc mal posé. La bonne ligne de partage n'est pas où le calcul a lieu, mais si vous pouvez voir où il a lieu et le changer. À ce compte-là, les architectures hybrides de 2026 ont fait de vrais progrès sur ce qui arrive à vos données pendant le traitement. Presque aucun sur ce que vous pouvez en savoir.