
Le push passe en local sans broncher. Dix minutes plus tard, le pipeline vire au rouge. On ouvre les logs, on ne trouve rien dans le diff, on relance le job : vert. Personne ne s'étonne plus. Le test fautif est connu, il "fait des siennes", et la CI repart.

C'est ce moment-là, pas un seuil de tests ni un logo de framework, qui marque la bascule. Une suite end-to-end cesse de rapporter le jour où l'équipe arrête de lire ses rouges. À partir de là, elle continue de coûter des minutes de CI, des migrations et des journées d'ingénieur, mais elle ne rend plus d'information exploitable. Le débat Playwright contre Cypress, aussi fourni soit-il en tableaux comparatifs, ne dit presque rien de cette bascule.
L'instabilité n'est pas un bug du framework
Un test instable produit un succès et un échec sur le même code, sans qu'aucune ligne n'ait bougé. Les causes sont documentées depuis longtemps. L'analyse de référence reste celle de Luo et ses coauteurs (FSE 2014), qui ont classé les correctifs de tests instables dans des projets Apache : près de la moitié des cas viennent d'attentes asynchrones mal posées - le fameux sleep(2) qui suffit sur un portable et plus sur un runner chargé. Vient ensuite la concurrence, autour de 20 % : ordre d'exécution, base de données partagée, deux tests qui se marchent dessus parce qu'ils tournent en parallèle.
Le reste est une collection de couplages : dépendance à une API tierce, horloge système non figée, données aléatoires non seedées, environnement qui diffère entre la machine du développeur et la CI.
Sur ce terrain, Playwright et Cypress ont apporté une vraie contribution, et il faut la leur reconnaître : l'auto-attente. Les deux frameworks savent quand un élément est actionnable, quand le réseau s'est stabilisé, quand le DOM a fini de bouger. La catégorie "attente asynchrone" - la plus grosse - est largement traitée au niveau du framework. C'est précisément pour cela que le choix de l'outil ne peut pas expliquer à lui seul la dégradation d'une suite.
Parce que le noyau dur reste architectural. Aucun runner ne vous sauvera d'une base de test partagée entre workers, d'un test qui suppose qu'un autre s'est exécuté avant lui, ou d'un paiement qui appelle le vrai prestataire. La parallélisation, en particulier, ne fait pas qu'accélérer : elle introduit des modes de défaillance qui n'existaient pas en séquentiel. Le rapport Bitrise Mobile Insights 2025, qui porte sur plus de dix millions de builds étalés de janvier 2022 à juin 2025, relève d'ailleurs une complexité de pipelines en hausse de 23 % sur la période - plus d'étapes, plus d'environnements, plus d'occasions de non-déterminisme.
Un test instable sur quatre mille, et le pipeline entier devient rouge
La statistique qui compte n'est pas le taux d'instabilité par test. C'est le taux par pipeline. Et le passage de l'un à l'autre est brutalement non linéaire.
Un test dont le taux d'échec parasite est de 0,01 % paraît inoffensif. Répétez-le 4 000 fois par build et la probabilité qu'au moins un échoue dépasse 30 %. À 0,03 %, elle approche 70 %. Il suffit d'un seul test rouge pour que tout le pipeline le soit. David Gomes a documenté ce cas concret sur une suite de plus de 4 000 tests : entre 30 % et 60 % des pipelines échouaient, sur la seule base de taux individuels minuscules.
À l'échelle de l'industrie, GitHub rapportait dès 2020 qu'un commit sur onze (environ 9 %) produisait au moins un build rouge causé par un test instable. Et la tendance n'est pas à l'amélioration : selon Bitrise, la part des équipes confrontées à des tests instables est passée de 10 % en 2022 à 26 % en 2025, soit une hausse de 160 % sur trois ans.
Cette arithmétique a une conséquence directe sur la question posée au départ. "Combien de tests E2E ?" n'est pas une question de couverture, c'est une question de coût marginal. Chaque test ajouté augmente linéairement la valeur espérée et, dans le même temps, augmente la probabilité de faux rouge de façon proportionnelle à la taille de la suite. Passé un certain volume, le deuxième effet domine. La suite grossit, le signal se dégrade, et le temps gagné en couverture est repris en triage.
Le coût dominant n'est pas le triage, c'est le signal
Les chiffres les plus cités viennent du billet de John Micco sur le blog d'ingénierie de Google, en 2016. Environ 1,5 % de tous les tests exécutés chez Google renvoyaient un résultat instable ; près de 16 % du parc de tests présentait de l'instabilité à un moment ou un autre ; et surtout, environ 84 % des transitions réussite→échec observées par la CI impliquaient un test instable.
Ce dernier chiffre circule souvent sous une forme approximative - "84 % des échecs sont de faux positifs" - ce qui n'est pas exactement ce que mesure le billet. La nuance importe, parce qu'elle déplace le problème. Ce que Google décrit, c'est une majorité de signaux rouges qui n'apprennent rien sur l'état du code. Et le billet lui-même en tire la conclusion gênante : "il est assez courant d'ignorer des échecs légitimes dans des tests instables, en raison du nombre élevé de faux positifs". Google note aussi que sa propre parade - ne signaler l'échec qu'après trois échecs consécutifs - réduit les faux positifs mais "encourage les développeurs à ignorer l'instabilité de leurs propres tests".
Voilà la formulation honnête du "coût plus élevé que le bénéfice" : ce n'est pas principalement une facture de licences ni même d'heures, c'est une perte de qualité de l'information. Une suite qui crie au loup coûte autant à faire tourner qu'une bonne suite et rend un résultat faux. En ce sens, une suite peu fiable est pire que pas de suite du tout : l'absence de suite laisse au moins l'équipe lucide sur ce qu'elle ne sait pas.
Les ordres de grandeur du temps humain existent, mais ils sont plus mous. Google évalue à environ 2 % du temps de développement le temps passé sur les tests instables ; une enquête citée par les agrégateurs - un sondage LambdaTest auprès de plus de 1 600 professionnels du test - avance plutôt 8 % du temps QA. Sur une équipe de développement de cinquante personnes, ces fractions se traduisent en plusieurs équivalents temps plein par an, mais le calcul reste un ordre de grandeur, pas une mesure. Le chiffre souvent repris d'un coût d'un million de dollars par an chez Microsoft est, lui, de seconde main et non daté : à ne pas utiliser comme argument massue.
Un point d'économie politique du secteur mérite d'être signalé : une bonne partie de la littérature sur l'instabilité est produite par des éditeurs qui vendent de la détection, du rerun intelligent ou du "self-healing" (TestDino, Mabl, Cypress Cloud, plates-formes de CI). Les données de Google, de GitHub ou de Bitrise sont réelles, mais elles circulent dans un écosystème où le problème est aussi un marché. Cela ne les invalide pas ; cela invite à ne pas confondre un benchmark d'éditeur avec une mesure indépendante.
Ce que le choix du framework change réellement
Alors, Playwright ou Cypress ? La question n'est pas nulle, elle est simplement mal hiérarchisée. Le framework ne pèse presque pas sur le taux d'instabilité, une fois l'auto-attente acquise dans les deux cas. Il décide en revanche de la ligne de coût récurrente, et c'est là que les écarts sont concrets.
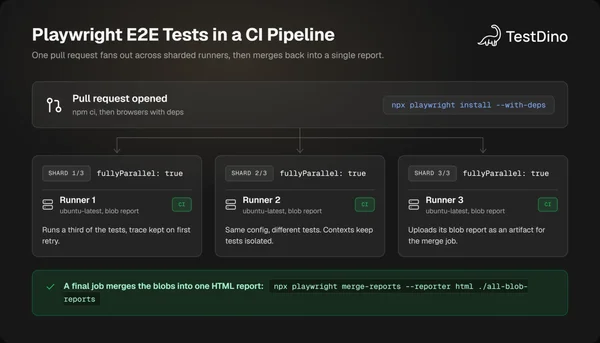
Côté Playwright : la parallélisation et le sharding sont dans le runner open source, sans palier commercial. Les contextes de navigateur isolent chaque session de test sans relancer un navigateur complet, ce qui permet de faire tourner plusieurs dizaines de tests simultanément sur une machine de CI à huit coeurs. Le traçage est inclus. WebKit est couvert, donc Safari. Les onglets multiples et les parcours multi-origines fonctionnent. Matthew Gorzelinski, qui a réécrit sa propre suite de tests dans les deux frameworks après une migration de stack, mesure Playwright "environ trois à quatre fois plus rapide" que Cypress sur Chromium, en exécution parallèle.
Côté Cypress : la parallélisation sérieuse passe par Cypress Cloud, un service commercial, là où Playwright l'inclut dans l'outil gratuit. Le moteur reste limité à la famille Chromium, le support multi-onglets et multi-origines est faible, l'expérimentation WebKit ne remplace pas une couverture Safari. En face, l'expérience de première heure reste la meilleure du marché : Test Runner interactif, débogage par voyage dans le temps, boucle de développement immédiate.
La conclusion pratique dépend donc de la taille et de la forme de l'application, pas d'un classement général. Une petite équipe JavaScript, sur une application mono-origine, dans un écosystème Chromium, avec une suite de quelques dizaines de tests, n'atteindra jamais le mur de la parallélisation payante : elle paiera en revanche plus cher la migration vers Playwright qu'elle ne récupérera en minutes de CI. À l'inverse, dès qu'une suite dépasse quelques centaines de tests, que le besoin de Safari est réel et que le pipeline devient le goulot d'étranglement, l'écart de coût d'infrastructure devient structurel - et il croît avec le volume.
Un dernier élément rebat les cartes, sans aller forcément dans le bon sens : la génération assistée par IA. Le serveur MCP de Playwright permet à un assistant de piloter un vrai navigateur, de lire l'arbre d'accessibilité et de proposer des localisateurs calés sur l'état réel de la page. Une étude de TTC Global citée dans les comparatifs 2026 mesure un gain moyen de 24,9 % du temps d'écriture de tests. Mais écrire des tests plus vite, c'est aussi produire de la maintenance plus vite. Si le goulot d'étranglement est le triage et non l'écriture, l'IA déplace la file d'attente sans la réduire. Et l'observation de ThinkSys reprise par ces mêmes comparatifs - 74,6 % des équipes QA utiliseraient au moins deux frameworks - suggère que la vraie question de 2026 n'est plus "lequel choisir" mais "quel outil possède quelle surface".
Les règles qui décident si une suite paie
Il n'existe pas de nombre magique de tests E2E, et aucun framework ne publie de point de bascule. En revanche, quelques règles tranchent la plupart des cas.
Compter ce que la suite est seule à attraper. Un test end-to-end se justifie sur les parcours qui traversent plusieurs systèmes : authentification, paiement, droits d'accès, tunnel de commande. Tout ce qui peut être vérifié par un test unitaire ou d'intégration coûte moins cher en bas de la pyramide, et rapporte autant. La couverture E2E n'est pas une vertu en soi ; c'est une dépense à justifier parcours par parcours.
Quarantaine puis suppression, dans un délai fixé. Microsoft a réduit son instabilité globale de 18 % en six mois avec une politique simple : corriger ou supprimer dans les deux semaines. Supprimer est une issue légitime. Un test que plus personne ne croit a une valeur négative : il coûte des minutes et falsifie le signal.
Traiter les reruns comme un instrument de mesure, pas comme un correctif. Un test qui ne passe qu'à la deuxième tentative est instable, point. Le rerun automatique évite de bloquer une pull request, il ne répare rien : il faut l'enregistrer et le compter.
Investir dans l'isolation plutôt que dans le triage. Base de données par worker, jeu de données déterministe, horloge figée, appels tiers simulés. C'est là que passe le budget d'ingénierie qui évite les cinq années de triage qui suivent.
Piloter le taux d'échec par pipeline, pas par test. C'est la seule métrique qui prédit si quelqu'un lira encore le rouge dans six mois. Une suite dont 30 % des exécutions échouent pour de mauvaises raisons n'est plus un filet de sécurité : c'est un bruit de fond payant.
La bascule n'arrive pas quand la suite atteint un certain nombre de tests, ni quand on choisit le mauvais framework. Elle arrive quand la réponse à un build rouge devient "relance". À ce moment-là, la seule manoeuvre qui restaure de la valeur n'est pas une migration vers un autre outil : c'est de la soustraction. Moins de tests, mieux isolés, sur les parcours qui comptent - et une suite qu'on peut croire quand elle dit non.