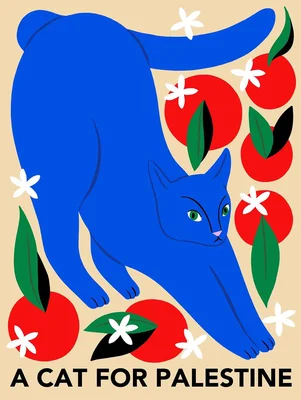

Le 26 avril 2026, une utilisatrice de Canva publie sur X une capture avant-après de son affiche. Avant : "cats for Palestine". Après : "cats for Ukraine". Elle n'a rien tapé, rien validé, rien demandé. Elle a pressé un bouton, "Magic Layers", et l'outil a réécrit son texte à sa place. Son message atteindra plusieurs millions de vues.

Magic Layers est l'une des briques phares de la refonte "AI 2.0", que Canva présente comme marquant le début d'une "nouvelle ère de la création". Sa fonction est mécanique : découper une image plate - une affiche, un visuel exporté - en calques séparés et modifiables. Le fond d'un côté, les éléments graphiques de l'autre, le texte isolé dans sa propre couche. En théorie, l'outil ne modifie pas le contenu. En pratique, il l'a fait, et sur un seul mot.
"Gaza" intact : le détail qui oriente le diagnostic
C'est le point le plus intéressant de l'affaire, et il est passé relativement inaperçu. Dans le même fil, l'utilisatrice précise avoir testé un visuel contenant "Gaza" : aucune modification. The Verge, qui a documenté l'incident le 27 avril, rapporte que le problème semblait limité au mot "Palestine". Plusieurs réponses au message viral indiquent que d'autres utilisateurs ont reproduit le dysfonctionnement avant le correctif ; après celui-ci, les tests du journal n'ont plus rien montré.
Cette asymétrie a une valeur diagnostique. Si Canva avait appliqué une liste de blocage géopolitique large - "Palestine", "Gaza", "Cisjordanie" et ainsi de suite -, c'est tout ce vocabulaire qui aurait sauté. Ce n'est pas ce qui s'est produit. Le comportement observé ressemble davantage à une association spécifique apprise par un modèle : un mot isolé, fortement corrélé dans les données d'entraînement à des images de conflit, de destruction ou de manifestations, donc traité différemment d'un terme voisin jugé moins chargé.
L'hypothèse la plus plausible reste technique. Pour transformer une image plate en calques, Magic Layers doit "lire" le texte incrusté, généralement via un modèle de reconnaissance de caractères ou de description d'image. Ce modèle interprète, devine, parfois hallucine. Une substitution lexicale à cette étape est le scénario le plus économique. Mais Canva ne l'a jamais confirmé : il faut donc le présenter pour ce qu'il est, une explication possible, pas un fait établi.
Une excuse, pas d'explication du mécanisme
La réaction de l'entreprise a été rapide. Le 27 avril, Canva répond publiquement à l'utilisatrice : "Cela n'aurait pas dû se produire et nous sommes vraiment désolés pour votre expérience. Notre équipe a enquêté et déployé un correctif pour éviter que cela ne se reproduise."
À The Verge, la porte-parole de Canva, Louisa Green, ajoute : "Nous avons eu connaissance d'un problème avec notre fonctionnalité Magic Layers et nous nous sommes mobilisés rapidement pour enquêter et le corriger. C'est maintenant résolu, et nous mettons en place des contrôles supplémentaires."
La communication de crise est bien exécutée : reconnaissance, excuse, correctif, engagement de sérieux. Et elle s'arrête là. Ni la réponse publique ni la déclaration faite à The Verge n'indiquent pourquoi "Palestine" a été remplacé, ni quelle couche du système a pris cette décision, ni si d'autres mots sont concernés. La promesse de "contrôles supplémentaires" reste la seule indication concrète livrée aux utilisateurs.
Faut-il y voir une volonté de ne pas s'expliquer ? Rien dans les éléments publics ne permet de trancher. Une enquête qui n'isole pas de cause identifiable débouche sur exactement les mêmes déclarations : on constate, on corrige, on ne décrit pas un mécanisme qu'on n'a pas su nommer. Le fait vérifiable est plus étroit, et il suffit : aucune explication du mécanisme n'a été fournie publiquement.
Bug ou décision de modération : l'angle mort du droit européen
C'est ici que l'affaire dépasse l'anecdote. Le règlement européen sur les services numériques (DSA) impose, à son article 17, un "exposé des motifs" aux hébergeurs. Lorsqu'ils restreignent la visibilité d'un contenu - retrait, désactivation de l'accès, déclassement -, suspendent des paiements, un compte ou un service, au motif que l'information est illégale ou contraire à leurs conditions générales, ils doivent dire à l'utilisateur concerné ce qui a été fait et pourquoi. L'exposé doit mentionner les faits et circonstances retenus, préciser si des moyens automatisés ont été utilisés pour décider, citer le fondement contractuel ou légal et indiquer les voies de recours : réclamation interne, règlement extrajudiciaire, recours devant un juge. Cette obligation s'applique au plus tard au moment où la restriction est imposée.
Le raisonnement a une fragilité qu'il faut nommer. Un mot silencieusement réécrit dans un projet personnel n'est pas, au sens strict, une "restriction de visibilité" d'un contenu fourni par l'utilisateur. Et si Canva qualifie l'incident de bug, le devoir d'exposé des motifs ne s'applique pas : l'article 17 vise les décisions de modération, pas les erreurs logicielles.
Mais retournez le problème. Si la substitution vient d'un filtre de sécurité traitant "Palestine" comme un terme sensible, alors une décision automatisée a bien été prise - et le point 3(c) de l'article 17 existe précisément pour forcer les plateformes à révéler ce type de traitement automatique. C'est tout l'intérêt de cet angle mort : selon la qualification retenue, les obligations ne sont pas les mêmes. Un bug logiciel n'a pas à être documenté pour chaque utilisateur ; une décision de modération, si. Cela ne dit rien des intentions de Canva - aucune de ses déclarations publiques ne permet de conclure qu'elle a identifié le mécanisme -, mais cela montre que le cadre européen ne couvre qu'une des deux hypothèses.
Le vrai coût : des filtres qu'on ne voit pas
Canva, plateforme australienne de création graphique, mène une course de vitesse contre Adobe sur les fonctionnalités assistées par IA. Dans cette compétition, la confiance n'est pas un supplément d'âme : c'est le produit. Un outil qui modifie le texte de l'utilisateur sans le prévenir détruit sa propre promesse, celle d'exécuter une intention et non d'en proposer une autre.

Le plus gênant n'est peut-être pas la substitution elle-même, aussi spectaculaire soit-elle. C'est ce qu'elle rend visible : l'existence d'une ou plusieurs couches capables d'altérer votre contenu, sur lesquelles l'éditeur ne fournit ni localisation, ni description, ni conditions de déclenchement. Pour un graphiste, un militant ou une association qui préparent une affiche sur un sujet sensible, la conséquence pratique est simple : impossible de savoir si le fichier final dit ce qu'il est censé dire sans le relire mot à mot.
Le contexte n'aide pas à relativiser. Des cas comparables ont été rapportés ailleurs : le générateur d'autocollants de Meta sur WhatsApp, qui aurait produit l'image d'un enfant armé en réponse à une requête sur la Palestine, ou Gemini, dont Google a suspendu la génération d'images faute de maîtriser ses propres filtres. Ces précédents, documentés surtout par des sources secondaires, demandent à être vérifiés. Ils indiquent en tout cas une chose : le problème n'est pas propre à Canva. Les garde-fous des grands modèles produisent régulièrement des effets collatéraux sur certains vocabulaires, et les utilisateurs n'en sont informés qu'après coup, par une publication virale.
Ce que ça change pour vous
Trois réflexes, à défaut d'une transparence qui n'existe pas.
Relisez systématiquement les calques de texte après un traitement automatique. Un outil qui "découpe" une image doit d'abord lire ce qu'elle contient : cette étape est une interprétation par un modèle, donc une source d'erreur possible. Vérifiez le résultat avant d'exporter.
Conservez toujours le fichier d'origine non traité, séparément. Si un outil réécrit un mot, c'est votre seule copie de référence.
Et lorsque vous le pouvez, gardez le texte en vrai texte plutôt qu'incrusté dans une image. Un calque texte éditable ne dépend pas d'un modèle pour être compris. C'est moins pratique à partager, c'est nettement plus fiable.
Reste la question technique, sans réponse. Canva a corrigé, s'est excusée, et n'a pas expliqué le mécanisme. Des mois plus tard, aucun retour détaillé de l'éditeur sur la cause n'a été publié. On peut y voir une stratégie - il est moins coûteux de reconnaître un bug que de documenter un filtre -, mais les éléments disponibles ne permettent pas de l'affirmer. Ce qui est certain, c'est que tant qu'aucun éditeur n'aura à rendre de comptes sur ce que font réellement ses couches invisibles, chaque utilisateur devra faire ce travail lui-même, mot après mot. Y compris pour les mots qui n'ont rien de politique.